Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124
Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124
蛋白质内在无序区域(Intrinsically Disordered Regions,IDRs)是指在生理条件下缺乏稳定三维结构、具有较高构象灵活性的蛋白质区域。与传统的有序结构域不同,无序区域通常具有较强的动态性,在蛋白质相互作用、分子识别、信号转导和转录调控等生物学过程中发挥重要作用。
随着 AlphaFold 等蛋白质结构预测工具的广泛应用,大规模蛋白质三维结构数据为研究蛋白质功能与进化提供了新的机会。然而,AlphaFold 等预测结果中常常会出现的低置信度区域,这些区域并不一定代表预测失败,也可能与蛋白质的内在无序特性有关。因此,识别蛋白质无序区域不仅有助于理解蛋白质的结构与功能特征,还可以为预测结构的质量评估、结构比较和后续功能分析提供参考。
本文介绍 metapredict 的安装方法、CentOS 7 等老旧 Linux 系统中常见的安装报错及解决方案,并通过简单实例展示其基本使用方法。
metapredict (https://github.com/idptools/metapredict) 是一个基于机器学习的蛋白质内在无序预测工具,可以根据氨基酸序列预测各个残基的无序评分,支持命令行和 Python API,可以用于单条蛋白质序列,也可以用于批量 FASTA 文件分析。需要注意的是,metapredict 预测的是序列的内在无序倾向,而 AlphaFold 的 pLDDT 反映的是预测结构的局部置信度。二者存在关联,但不能简单地将低 pLDDT 等同于内在无序。
官方提供了三种安装途径,pip、conda及uv。
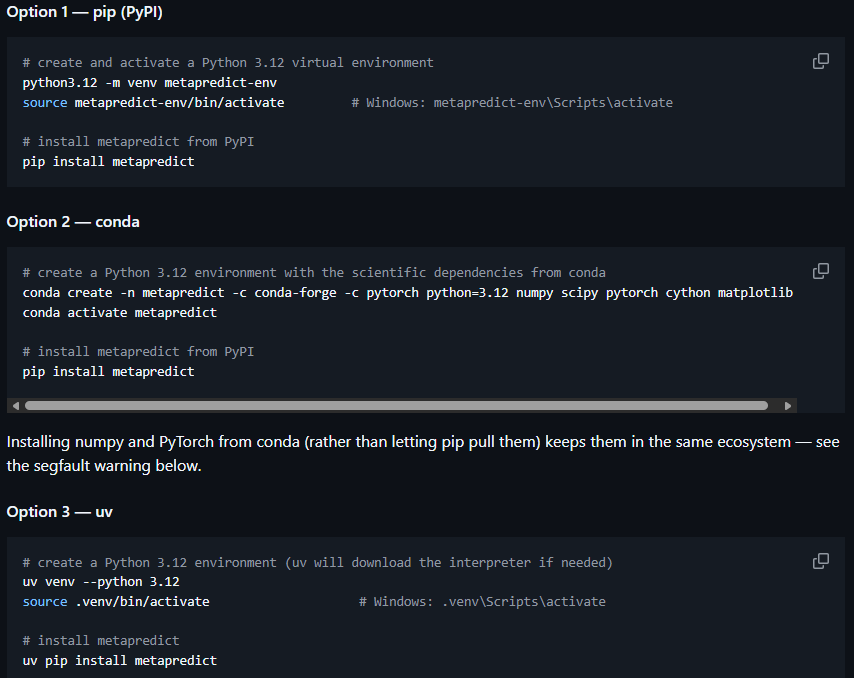
都不复杂这里不赘述。由于本人的机器的系统很老(CentOS 7),这里主要记录一下在老系统(CentOS 7)安装遇到的问题及解决办法。
首先是通过mamba(或conda)创建好依赖环境后,然后pip install metapredict会报错:
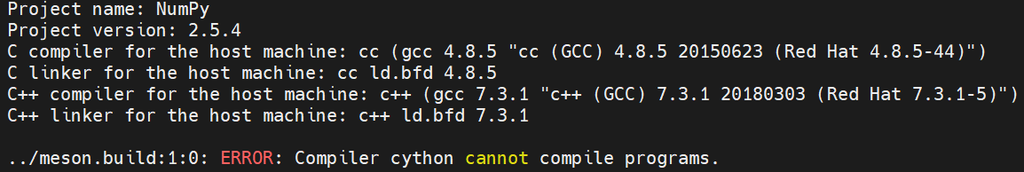
这应该是pip 尝试从源码编译 NumPy 2.5.4,但服务器的 GCC 版本太旧,导致编译失败。但前面创建环境时已经安装过numpy了,不知道为啥pip又要装一遍,所以尝试通过添加–no-build-isolation参数来避免安装时重新下载 、编译NumPy 源码,优先使用当前环境里已经安装的 NumPy 等依赖。


然后显示编译成功了,但尝试运行时还是报错:


好像是安装不完整,问AI说是没安装versioningit,让 pip uninstall -y metapredict,再pip install “versioningit~=2.0″,再重新编译。
这次就没再报错了。
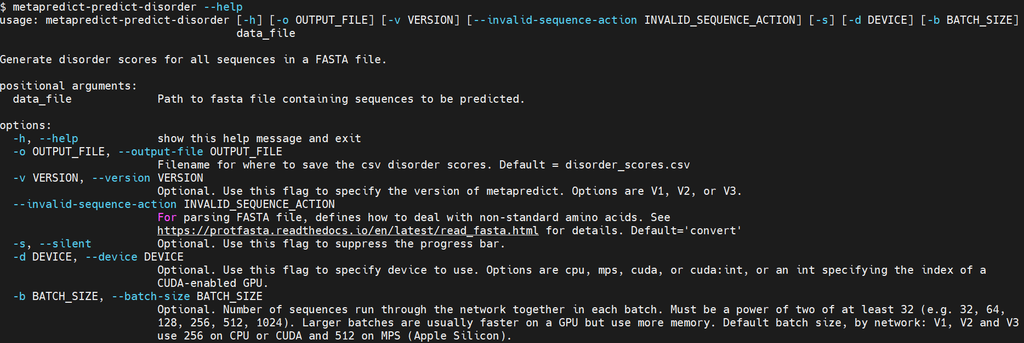
metapredict-predict-disorder test.fa -o test_disorder_predictions.csv -v 3 -d cuda:0 -b 32-o, –output-file 用于指定输出文件
-v, –version 用于指定metapredict的版本,V1,V2,或者V3,默认是V3
-d, –device 用于指定运行的设备,cpu,mps (for Apple Silicon),cuda,或者cuda:int
-b, –batch-size 用于指定并行序列的数量,最小为32,必须是2 的整数次幂
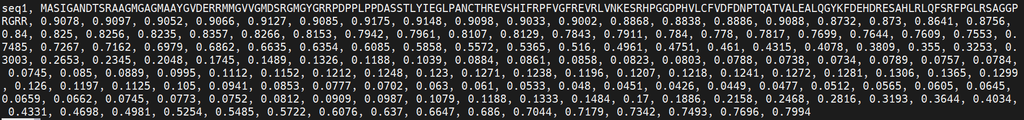
输出结果长这样,第一列是序列名,后面是序列,再后面是序列中每个氨基酸的无序评分,官方默认的阈值V1版本是0.42,V2和V3版本是0.5。
metapredict-graph-disorder test.fa -p -o test_plot -D 300-o, –output-directory 用于指定输出的目录(必须是已经存在的目录,不然会报错)
-v, –version 用于指定metapredict的版本,V1,V2,或者V3,默认是V3
-p, –pLDDT 加上这个参数就会在图里加上AlphaFold2 pLDDT scores(metapredict自己预测的,没测试是否和AF2跑出来的一样)
–filetype 指定输出图片的格式,png, pdf, jpg,默认是png
-D, –dpi 用于输出图片的dpi,默认是150
–disorder-threshold 用于指定图里的阈值
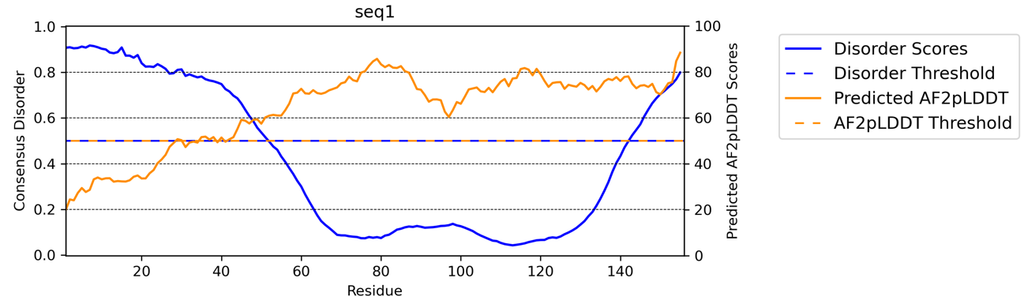
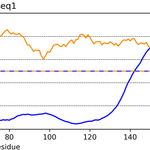
输出的图片长这样。
使用大约3万条蛋白序列测试软件预测的速度:
time metapredict-predict-disorder test3.fa -o test3_disorder_predictions.csv -v 3 -d cuda:0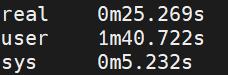
在GPU上跑还是很快的。
time metapredict-predict-disorder test3.fa -o test3-2_disorder_predictions.csv -v 3 -d cpu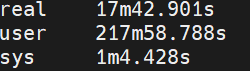
而在CPU上就要慢很多了,所以大批量预测还是要上GPU。